A SpaceXAI colocou no ar nesta segunda-feira (21) o Grok 4.7, nova versão do seu modelo de linguagem. A empresa vende a atualização como a mais capaz que já fez para escrever código e para o chamado trabalho intelectual: tarefas longas, com várias etapas, em que o modelo precisa seguir sozinho por mais tempo e conferir o próprio resultado antes de entregar.
Por baixo, a mudança é estrutural. O Grok 4.7 parte de um modelo base maior que o do antecessor e já nasce integrado ao Grok Bot, a estrutura de agentes da empresa pensada para funcionar como um “colega” dentro de ferramentas de trabalho.
Os números que a SpaceXAI mostrou
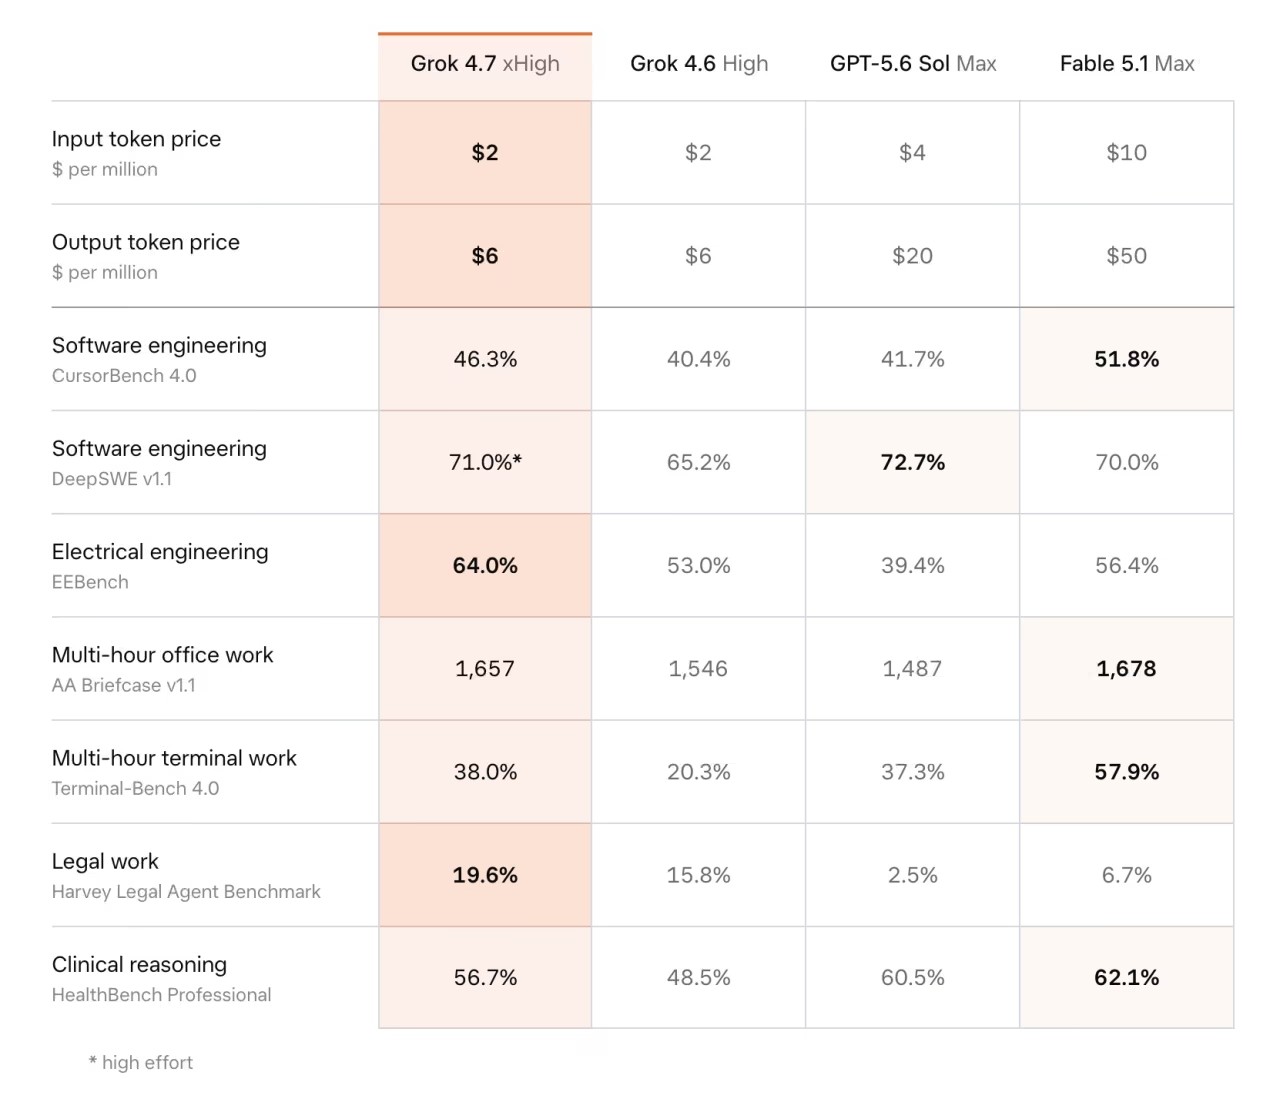
O destaque é o CursorBench 4.0, teste de programação de longa duração: o Grok 4.7 chegou a 46,3%, contra 40,4% do Grok 4.6 e 41,7% do GPT-5.6 Sol, da OpenAI. No Terminal-Bench, que mede a execução de tarefas em linha de comando, o salto foi de 20,3% para 38%. A empresa também cita 64% no EEBench (engenharia elétrica), 19,6% no teste jurídico da Harvey e 1.657 pontos no AA Briefcase, que avalia documentos e apresentações.
Há um porém que a própria tabela deixa claro: o Fable 5.1 continua na liderança em vários desses testes, com 51,8% no CursorBench 4.0, 57,9% no Terminal-Bench e 1.678 no AA Briefcase. Ou seja, o Grok encurtou a distância para o topo, mas não assumiu o primeiro lugar.
Segurança virou argumento de venda
A outra frente do lançamento é a resistência a abusos. A SpaceXAI diz ter refeito a camada de proteção do modelo e afirma que esta é a versão mais difícil de “quebrar” com jailbreak que já testou. Nos números divulgados, o Grok 4.7 fez 62,4% no LatchBio, benchmark de biossegurança, e aceitou só 3,3% dos comandos de risco no HackerBench v0.3. Parceiros de cibersegurança selecionados receberão acesso por convite para pesquisa defensiva.
Por que isso importa
A disputa entre modelos de IA se deslocou do chat para os agentes que programam e executam tarefas por conta própria, e é aí que empresas pagam por uso. Para quem desenvolve software no Brasil, o dado mais prático é o preço: o Grok 4.7 manteve a tabela do antecessor, US$ 2 a cada milhão de tokens enviados ao modelo e US$ 6 a cada milhão gerados por ele, bem abaixo dos modelos de topo concorrentes. Ele já pode ser escolhido no Cursor, no Grok Build e pela API. Como sempre, os benchmarks são da própria fabricante; a comparação que vale é a de cada um no seu código.