O Google publicou nesta quinta-feira (17) o Android Bench 2.0, nova versão do teste que usa para medir como modelos de IA se saem programando para Android. A mudança principal é o tamanho do desafio: em vez de pedir pequenos ajustes de código, o benchmark agora traz tarefas de longo horizonte (as LHTs), trabalhos que tomariam de alguns dias a uma semana de um desenvolvedor humano, como migrar dependências, implementar um recurso grande ou montar um aplicativo inteiro do zero.
A outra novidade está na régua. Até aqui, cada tarefa era aprovada ou reprovada. Na versão 2.0, o Google passou a medir também quanto do trabalho o agente conseguiu entregar, uma pontuação contínua que separa o modelo que parou na metade daquele que nem saiu do lugar.
Quem ganhou (e quem ficou para trás)
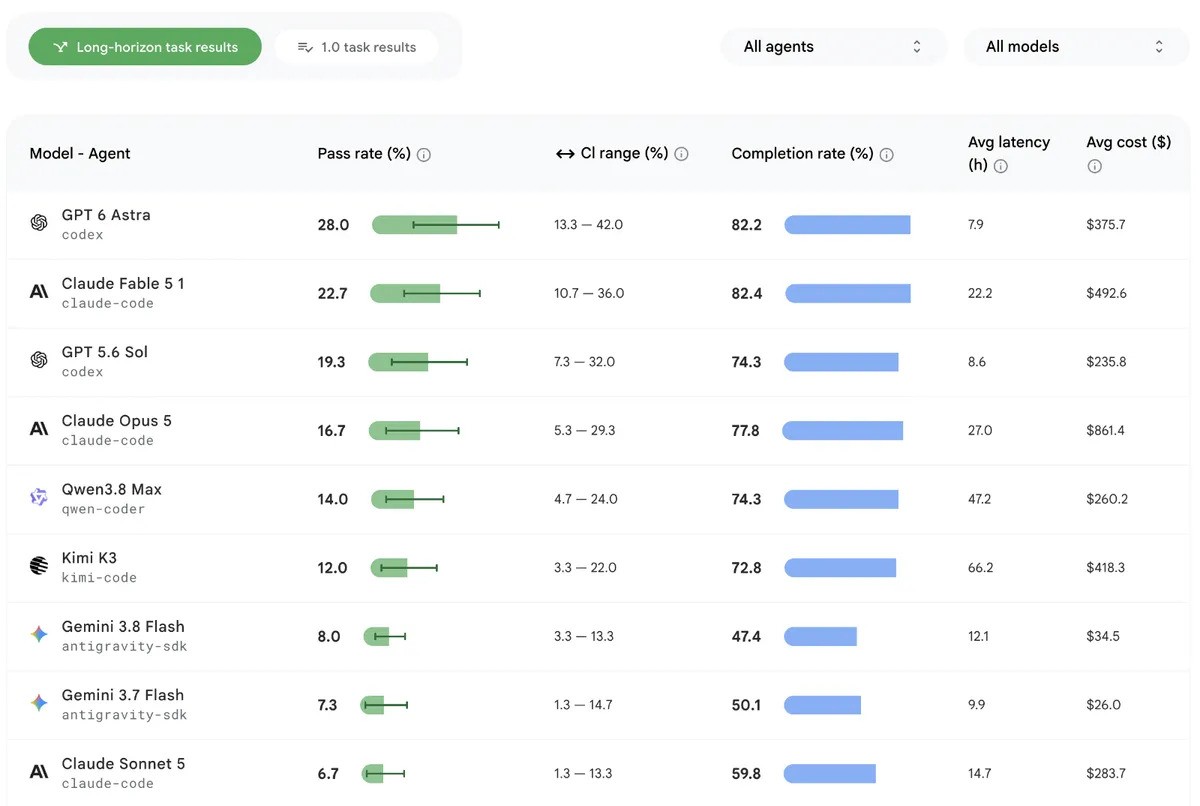
A tabela divulgada pelo Google coloca o GPT-6 Astra, da OpenAI, no topo, com 28% de aprovação nas tarefas longas usando o agente Codex. Logo atrás aparecem o Claude Fable 5.1, da Anthropic, com 22,7%, o GPT-5.6 Sol, com 19,3%, e o Claude Opus 5, com 16,7%. Qwen3.8 Max (14%) e Kimi K3 (12%) completam o pelotão do meio.
O dado que mais chamou atenção é o da casa: o Gemini 3.8 Flash marcou apenas 8%, e a geração anterior, o Gemini 3.7 Flash, 7,3%. Vale o contexto: o Google só colocou na lista os seus modelos Flash, que são a linha rápida e barata da família. Isso aparece na coluna de custo, em que o Gemini 3.8 Flash gastou em média US$ 34,50 por tarefa, contra US$ 375,70 do GPT-6 Astra e US$ 861,40 do Claude Opus 5.
A taxa de conclusão ajuda a ler os números baixos. Os líderes passam de 80% do trabalho entregue, mesmo quando não fecham a tarefa inteira; o Gemini 3.8 Flash para em 47,4%. Ou seja, os agentes já fazem a maior parte do serviço, mas ainda tropeçam no acabamento que um app de verdade exige.
O que muda para quem desenvolve
Para os desenvolvedores, o recado do Google é que o benchmark serve de guia na escolha da ferramenta: com trabalhos de vários dias, ficam mais visíveis os pontos fortes e fracos de cada modelo, e também as diferenças de custo e tempo. O GPT-6 Astra, por exemplo, levou em média 7,9 horas por tarefa, enquanto o Claude Opus 5 precisou de 27 horas.
No Brasil, onde boa parte dos apps é mantida por equipes enxutas, esse tipo de comparação ajuda a decidir se compensa pagar mais por um agente que conclui mais tarefas ou usar um modelo barato e revisar o resultado à mão.